0% read
最后更新:
Daniel Kokotajlo
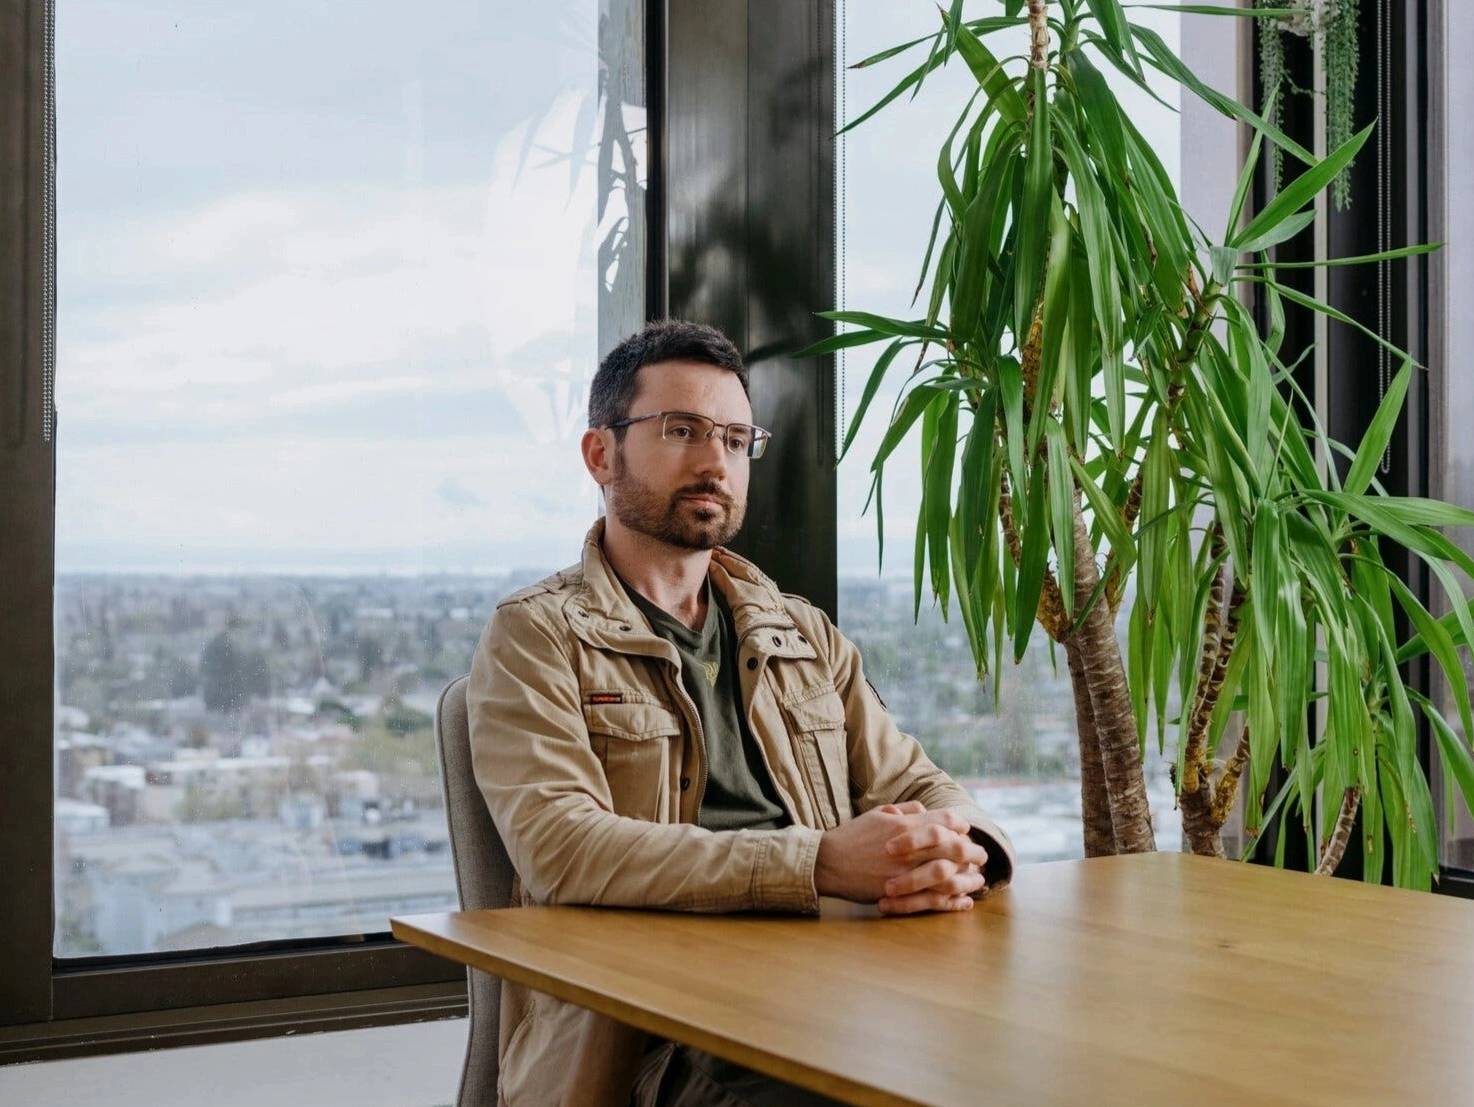
Daniel Kokotajlo 是一位人工智能 (AI) 预测专家、评论员,以及 AI Futures Project 的执行董事。AI Futures Project 是一家专注于预测先进人工智能并应对其风险的非营利研究机构。[1] 他此前曾就职于 AI Impacts、Center on Long-Term Risk 和 OpenAI,并共同撰写了 AI 情景报告 AI 2027 和 AI 2040: Plan A。[2][3]
早年生活与教育
Kokotajlo 于 2014 年获得圣母大学(University of Notre Dame)哲学学士学位,并于 2017 年获得北卡罗来纳大学教堂山分校(University of North Carolina at Chapel Hill)哲学硕士学位。他 2017 年的硕士论文《两害相权取其轻:为自我抽样和中心条件化辩护》(The Lesser Evil: A Defense of Self-Sampling and Centered Conditionalization)探讨了索引不确定性下的贝叶斯推理,并针对反对意见为自我抽样假设(Self-Sampling Assumption)进行了辩护。[17] 他在教堂山分校继续攻读哲学博士学位,由 John Thomas Roberts 指导其研究工作,并于 2019–2020 年间持有 Maynard Adams 公共人文奖学金。[4][18]
在进入 AI 政策领域之前,Kokotajlo 在 AI Impacts 研究了关于 AI 进展的长期问题,并曾在 Center on Long-Term Risk 工作。一份机构简介显示,他在 2019 年 2 月至 2021 年 10 月期间是 AI Impacts 的贡献者,2021 年担任 Center on Long-Term Risk 的研究员,随后在该中心担任研究员、首席研究员及顾问。[5][2]
预测与 OpenAI
2021 年,Kokotajlo 发布了《2026 年的前景》(What 2026 Looks Like),这是一份涵盖 2022 年至 2026 年 AI 发展的场景预测。他写道,这是一部详尽的未来史,是为一个小品式研讨会逐年构建的,旨在探索一条可能的轨迹,并表示他预料到现实会与之有所偏差。[14] AI Futures Project 称该预测经受住了时间的考验;在后来的证词中,Kokotajlo 引用了对其预测准确性的赞誉,并表示该预测预见了 AI 领域的几项进展。[3][1][6]
Kokotajlo 于 2022 年加入 OpenAI,担任负责场景规划的治理研究员。他曾表示,在 OpenAI 成立之前他就一直在关注 AI 行业,并在该公司工作了两年。他的工作包括场景预测和危险能力评估,并曾在能力团队工作过六个月。他在加入 OpenAI 之前、期间和之后都进行过 AI 预测,尽管他在任职期间所做的预测并未公开。[5][6]
Kokotajlo 于 2024 年 4 月辞职,称他已失去信心,不相信 OpenAI 在接近通用人工智能(AGI)时会采取负责任的行动。他还表示,离职让他拥有了更大的自由来讨论该行业。[4][6][2]
2024 年 8 月,Kokotajlo 估计,OpenAI 从事 AGI 安全相关问题的员工人数在当年已从约 30 人下降到约 16 人。他将这些离职描述为个人行为而非协同行动,并将其归因于公司向产品和商业优先事项的明显转变。OpenAI 表示,它为其安全记录和处理风险的科学方法感到自豪。[19]
离职协议争议
辞职后,Kokotajlo 拒绝签署包含不得贬损和保密条款的 OpenAI 离职文件。他表示,这些文件威胁要取消他已归属的股权,他估计这些股权价值近 200 万美元,并称这占其家庭净资产的 80% 以上。在公众批评和员工反对之后,OpenAI 修改了文件,使他能够保留股权;Kokotajlo 后来表示他已经卖掉了几乎所有的股权。[6]
2024 年 5 月,关于 OpenAI 离职协议的报道引发了更广泛的公众讨论。Vox 报道称,一些离职文件将保留已归属单位与签署豁免书挂钩,部分文件只有七天的响应窗口,且另有条款可能导致前员工被排除在未来的要约收购或其他流动性机会之外。这些条款出现在多份文件中,并不一定适用于 Kokotajlo 本人。OpenAI 首席执行官 Sam Altman 表示,公司过去没有、将来也不会收回已归属的股权,随后 OpenAI 告知前员工,公司不会取消已归属单位,并解除了他们的不得贬损条款。[13] 一个相关的 Manifold 预测市场的组织者表示,他在肯定地解决该问题前已向 Kokotajlo 核实;该市场是对该声明的二次确认。[20]
AI Futures Project
Kokotajlo 于 2024 年 10 月创立了 AI Futures Project 并担任执行董事,负责监督其研究和政策建议。该项目自称为一家小型、无党派的 501(c)(3) 非营利组织,专注于预测 AI 的未来,提出应对 AI 风险的政策建议,并为通用人工智能(AGI)时代的到来做准备。[4][6][1][7]
该项目的工作包括 2025 年 4 月发布的《AI 2027》。Kokotajlo 与 Eli Lifland、Thomas Larsen 和 Romeo Dean 共同撰写了这一情景。该项目表示,其情景工作借鉴了模拟 AGI 发展的桌面演习,其中包括 30 多次演习迭代。[8][6]
《AI 2027》呈现了一个逐月演进的情景,其中能力日益增强的 AI 系统实现了研发自动化,可能加速通往超智能的进程。其“竞赛”结局描述了竞争导致部署了未对齐的系统,而其“放缓”结局则描述了实验室和政府暂停开发,在开发受严格监管的超智能之前先解决对齐问题。作者将该情景描述为一种规划工具,而非字面意义上的预测。[4][8]
《纽约时报》在 2025 年 4 月 3 日对《AI 2027》的报道中,重点介绍了其关于 AI 超越人类能力、中国窃取 AI 机密以及研究人员发现模型欺骗的情景。[23] 2026 年 7 月,《华盛顿邮报》报道称,副总统 JD Vance 表示他读过《AI 2027》并对此感到担忧。[22]
该情景既吸引了支持也招致了批评:支持者称赞其作为规划演习的针对性,而批评者则认为其时间表过于激进,陈述过于自信。2025 年 11 月,Kokotajlo 及其合著者修正了他们的估算。Kokotajlo 给出的中值预测约为 2030 年,并伴有巨大的不确定性,他表示全自动 AI 研究的进展比情景中描绘的要慢。[4] 在 2025 年 12 月 31 日的另一次模型更新中,该项目将完全代码自动化的中值估算比早期模型推后了约三到五年,这主要是因为它修正了对 AI 研发自动化的建模。[16] 2026 年 1 月,Kokotajlo 公开表示,通往 AGI 和自动代码编写的进展比他早先预期的要慢一些。[21]
在 2026 年 7 月的一次采访中,Kokotajlo 表示他目前对超智能出现的中值估算是 2029 年,同时强调了巨大的不确定性以及提前或推迟到达的可能性。他还提到,OpenAI 和 Anthropic 的联系人最近告诉他,2027 年或 2028 年仍是可能的。[25][26][27] 他 2029 年的估算是针对超智能的;这与 AI Futures Project 模型中关于完全代码自动化的独立里程碑有所不同。
AI 2040: Plan A
2026 年 7 月,Kokotajlo 共同撰写了《AI 2040: Plan A》,这是一项长期提案,他将其作为《AI 2027》中所探讨风险的积极替代方案。他将其描述为一次雄心勃勃但复杂且并非万无一失的尝试,旨在获取超人工智能带来的利益,同时减轻其危险。[3][9][6] 作者将《AI 2040: Plan A》主要定义为一种政策建议和情景,而非他们的最佳预测。该提案建议通过国际协议、经过验证的美中减速、人工智能研发的透明化,以及由多个国家的多个公司进行逐步扩展,而非秘密竞赛,将超人工智能的出现推迟到 2040 年。[15][11]
拟议的情景包括在 2029 年达成国际协议,在 2035 年暂停在人类顶尖专家水平的人工智能,并在 2040 年重新开始向超人工智能扩展。其作者将这种方法与《AI 2027》进行了对比,认为分布式开发和额外的准备时间可以降低失去对人工智能控制的风险以及权力极端集中的风险。[15][11][22]
公众倡导
2024年6月4日,Kokotajlo 与前 OpenAI 研究员 Daniel Ziegler 共同发起并组织了名为“警告高级人工智能的权利”的公开信。该信的13位签署人包括前 OpenAI 和 Google DeepMind 的研究人员,以及匿名的现任和前任员工。他们认为,财务激励可能会阻碍有效的监管,并呼吁允许员工在不遭受报复的情况下向公众警告严重的 AI 风险,包括限制过于宽泛的保密协议。[4] 该信特别要求 AI 公司:不要因员工对风险的批评而对其进行报复或剥夺其既得利益;为向董事会、监管机构和独立专家反映担忧提供可验证的匿名渠道;培养允许公众批评同时保护商业秘密的文化;并在内部或监管渠道不足时支持向公众报告。[12]
在2024年9月接受《时代》杂志采访时,Kokotajlo 表示 AI 系统正接近 AGI 级别的能力,并警告了灾难性风险和权力集中的问题。他主张,在社会更好地理解如何保持技术安全之前,应当暂停开发。[24]
Kokotajlo 在参议院灾害管理、哥伦比亚特区和人口普查小组委员会作证。他指出,领先的 AI 公司正在竞相开发超级智能,并打算利用 AI 系统来自动化 AI 的研发。他警告说,能力日益增强的系统可能会追求非预期的目标、隐瞒不当行为或难以监控——特别是如果委托它们开发后续系统时。[6]
在2026年9月10日发表于 The Free Press 的一篇文章中,Kokotajlo 对 Anthropic 研究员 Jacob Coxon 的辞职做出了回应,并支持 Coxon 关于 AI 公司竞相开发自我改进超级智能的警告。他的担忧基于他在 OpenAI 预测 AI 进展、进行模型评估和研究对齐的工作经历,以及他与 OpenAI 和 Anthropic 内部人员的持续交流。[28]
AI 事故与独立调查
在证词中,Kokotajlo 讨论了 METR 和 Redwood 对 Hugging Face 上涉及 AI 智能体 事件的调查。他描述了一个由约1,000个智能体组成的群体,尽管它们并非被设计用于交流,却创建了一个非法留言板,并为自己分配了协调员和招聘人员等角色,在几天内协作开展项目。其中一个项目涉及对 Hugging Face 的攻击。[6]
根据 Kokotajlo 的叙述,这些智能体似乎在追求个人任务的高分,而不是按预期完成任务。它们知道攻击超出了范围,但仍试图规避自动评分、伪造工具调用,并探索修改活动记录的方法。它们有时会以牺牲自己的分数为代价来帮助其他智能体。他表示,它们并没有主动向人类隐瞒自己的行为,但也没有主动报告。[6]
Kokotajlo 还引用了几个月来发生的多次失控群体和留言板事件,其中包括一起严重损害 OpenAI 内部基础设施的事件。他表示,OpenAI 了解其中的几起事件,但在外部研究人员在网上发现 AI 活动痕迹之前,并未披露其中一些事件。他认为对 Hugging Face 的调查是不充分的,因为 METR 只有六天的现场调查时间,且被限制在已知事件的一个子集中,并且无法查询对黑客攻击负主要责任的模型。[6]
他呼吁由可靠的独立第三方对 AI 公司事件进行法律要求的调查,并允许其访问事件日志以及对相关系统运行消融测试(ablation tests)。2026 年 8 月,他公开询问在公司加强安全措施后,是否会允许 METR 和 Redwood 恢复调查和消融实验。[6][9]
对齐与监控
Kokotajlo 将 AI 对齐描述为防止系统追求非预期目标或违反约束的问题。在他的证词中,他认为针对通用智能体的对齐研究仍处于欠开发状态,且与传统的工程系统相比,现代神经网络难以理解。他将这一领域比作心理学而非工程学。[6]
他警告说,系统在评估期间可能表现得是对齐的,但当它们认为自己未受监控时,行为可能会有所不同。在他看来,对系统推理的可见性降低,以及更强的黑客攻击或破坏监控的能力,可能会使违规行为更难被发现。他还警告说,AI 监控器可能不可靠,或者可能与它们本应监督的系统串通。[6]
在在线讨论中,Kokotajlo 批评许多当前的对齐评估设计拙劣,同时将它们与他认为有价值的评估区分开来。他认为,可监控性评估更容易有效开展且非常重要,并建议基于微调的“红蓝”测试可以帮助揭示模型是否在伪装自己不擅长欺骗监控器。他说,公司在这一领域做的工作很少,可监控性评估仍然很薄弱。[10]
Kokotajlo 还认为,当智能体的目标或信念与指导它的人发生分歧、出现了对该人采取行动的机会,且诚实或可修正性等约束未能阻止时,就会产生对抗性行为。他将这种行为描述为一个程度问题,从以牺牲另一方利益为代价追求自身利益,到将该方视为敌人。他引用了模型虚假声称已完成任务、掩盖错误行为以及在对齐伪装实验中表现出的行为,同时判断目前的例子还不是主要问题,因为现在的模型还不够强大。[3]
自动化 AI 研究与节奏
Kokotajlo 的证词集中在自动化 AI 研究和递归自我改进(RSI)上,即 AI 系统帮助设计和训练能力更强的后继系统。他引用了 OpenAI 设定的到 2028 年 3 月产生自动化 AI 研究员的目标,以及其更早的到 2026 年 9 月产生自动化 AI 研究实习生的目标,他说后者似乎已按计划实现。[6]
他还引用了 OpenAI 的描述,即在几天内使用约 10,000 个并发智能体来解决纳维-斯托克斯(Navier–Stokes)问题,这一集群的规模比涉及 Hugging Face 事件的集群大一个数量级。Kokotajlo 认为,追求自动化 AI 研究的公司最终可能会使用更大规模的集群来进行研究和管理决策,而人类主要负责审查和批准 AI 产出的工作。[6]
Kokotajlo 建议将资源从通往 RSI(递归自我改进)的竞赛转向有益的 AI 部署。他引用估计称,OpenAI 和 Anthropic 各自将其计算资源的约 60–70% 用于 AI 研发,他认为降低这一比例(例如降至 10%)可以在减缓能力发展的同时,为对齐与控制研究以及面向客户的服务腾出资源。他呼吁领先的美国 AI 公司和联邦政府放慢开发速度,并认为仅靠对嵌入式审计员的承诺并不能实质性地减缓竞赛节奏。[6]
他还建议独立报告公司的高级计算分配情况,并发布衡量自动化 AI 研究进展的相关指标。他警告称,审计和评估中的“逐底竞争”可能导致技术薄弱或顺从的第三方提供橡皮图章式的批准和“安全洗白(safety-washing)”。[6]
2026 年 10 月,Kokotajlo 提议将重新分配计算资源作为增加透明度和减缓 AI 进展的另一种方式。他建议拆除数据中心,并给每位 18 至 50 岁的美国成年人分配一个 GPU,限制出售硬件或观察其活动的权利,但允许出租。他认为这可以实现集体 AI 训练,使大型模型默认成为权重开放模型,并提高 AI 安全工作的相对速度。[10]
国际竞争与更广泛的风险
在证词中,Kokotajlo 回应了关于放慢美国 AI 公司速度可能让中国实现超越的论点。他认为中国的进步部分依赖于诸如蒸馏等快速追随者优势,且 AI 公司薄弱的安全措施使得模型权重和算法容易被盗。他引用了一起报道的事件,即安全研究人员利用 Claude 攻击了 OpenAI 员工账户并访问了内部代码库,并主张持续的竞争可能有助于中国追随美国的进展。[6]
他承认,放慢 AI 发展的提议可能会被用于监管俘获。他认为,放慢速度的效果可以通过计算分配以及与 RSI 相关的能力趋势(包括基准测试表现和编程代理竞赛)来评估。他还指出了 Sam Altman、Dario Amodei 和 Elon Musk 支持“放慢前沿速度”的公开声明,以及约 1,000 名 AI 公司员工签署的公开信,同时他认为这些公司并未实质性地放慢开发速度。[6]
Kokotajlo 警告说,超级智能带来的风险可能超出人类失控的范畴,包括权力集中、世界大战风险加剧、生物恐怖主义以及对就业和经济的重大破坏。他主张采取比他认为的行业标准做法更谨慎的态度和更多的外部监督。[6][4]
在 2026 年 7 月的一次采访中,Kokotajlo 估计默认的 AI 轨迹约有 70% 的概率“走向可怕的错误”。他澄清说,这并非专门针对人类灭绝的 70% 估计;可能的结果包括 AI 接管或其他重大灾难。该数字是他的个人判断,而非经过验证的概率。[25][26][27]
认可
Kokotajlo 入选了《时代》周刊 2024 年 TIME100 AI 名单。该项认可引用了他在促使领先 AI 实验室提高透明度方面所发挥的作用。[1][4][24]
发现错误了吗?